1.プログラミングについて
2.使用方法
| Pythonでできること | 2026-09-08 |
3.動作環境を用意する
| Homebrewインストール | 2025-08-25 |
| Pythonインストール | 2025-08-23 |
| Pythonインストール確認 | 2025-08-22 |
VSコード(Visual Studio Code)に関しては 開発環境(ツール) を参照
4.演習
| Python学習 | 2025-03-27 |
| Pythonでできること | 2026-09-08 |
| Homebrewインストール | 2025-08-25 |
| Pythonインストール | 2025-08-23 |
| Pythonインストール確認 | 2025-08-22 |
VSコード(Visual Studio Code)に関しては 開発環境(ツール) を参照
| Python学習 | 2025-03-27 |
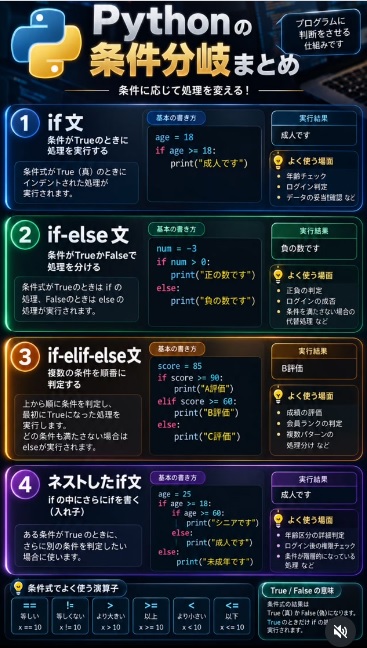
| if文 | 条件がTrueのときに処理を実行する 条件式がTrue(真)のときに インデントされた処理が実行される 基本の書き方 age = 18 if age >= 18: print(“成人です”) 実行結果 成人です よく使う場面 年齢チェック ログイン判定 データの妥当確認など |
| if-else文 | 条件がTrueかFalseで処理を分ける 条件式がTrueのときは ifの処理 Falseのときは elseの処理 基本の書き方 num = -3 if num > 0: print(“正の数です”) else: print(“負の数です”) 実行結果 負の数です よく使う場面 正負の判定 ログインの成否 条件を満たさない場合の代替処理 |
| if-elif-else文 | 複数の条件を順番に判定する 上から順に条件を判定し、 最初にTrueになった処理を実行 どの条件も満たさない場合は elseが実行される 基本の書き方 score = 85 if score >= 90: print(“A評価”) elif score >= 60: print(“B評価”) else: print(“C評価”) 実行結果 B評価 よく使う場面 成績の評価 会員ランクの判定 複数パターンの処理分け |
| ネストしたif文 | if の中にさらにifを書く (入れ子) ある条件がTrueのときに、 さらに別の条件を判定したい場合 基本の書き方 age = 25 if age > 18: if age >= 60: print(“シニアです”) else: print(“成人です) else: print(“未成年です) 実行結果 成人です よく使う場面 年齢区分の詳細判定 ログイン後の権限チェック 条件が階層的になっている処理 |
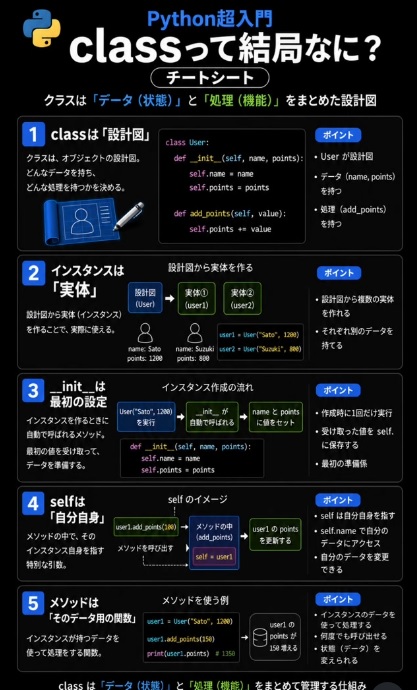
| classは「設計図」 オブジェクトの設計図 どんなデータを持ち、 どんな処理を持つかを決める | 例class User: def __init__(self, name, points): self.name = nameself.points = points def add_points(self, value): self.points += valueポイント User が設計図 データ(name, points)を持つ 処理(add_points)を持つ |
| インスタンスは「実体」 設計図から実体を作る 設計図から実体を作ることで、 実際に使える | 設計図(User)から 実体1(User1)と 実体2(User2)を作る 例 user1 = User(“Sato”, 1200) user2 = User(“Suzuki”, 800) ポイント設計図から複数の実体を作れる それぞれ別のデータを持てる |
| __init__ は「最初の設定」 インスタンスを作るときに 自動で呼ばれるメソッド 最初の値を受け取って、 データを準備する | インスタンス作成の流れUser("Sato", 1200)を実行__init__ が自動で呼ばれるname と points に値をセット例 def __init__(self, name, points):self.name = nameself.points = pointsポイント 作成時に1回だけ実行 受け取った値をselfに保存する 最初の準備係 |
| selfは「自分自身」 メソッドの中で、 そのインスタンス自身を指す 特別な引数 | selfのイメージ 例 user1.add_points(100)を実行メソッドの中は add_pointsメソッドを呼び出しself = user1user1のpointsが更新されるポイント selfは自分自身を指す self.nameで自分のデータに アクセス 自分のデータを変更できる |
| メソッドは「そのデータ用の関数」 インスタンスが持つデータを 使って処理する関数 | メソッドを使う 例 user1 = User("Sato", 1200) user1.add_points(150) print(user1.points)user1のpointsが150増える 実行結果→ 1350 ポイント インスタンスのデータを使って処理 何度でも呼び出せる 状態(データ)を変えられる |
class User:
 def __init__(self, name, points):
  self.name = name
  self.points = points

 def add_points(self, value):
  self.points += value
user1 = User("Sato", 1200)
user2 = User("Suzuki", 800)def __init__(self, name, points):
self.name = name
self.points = points user1 = User("Sato", 1200)
user1.add_points(150)
print(user1.points)自動化・Web・データ分析・AI分野で活躍
| 主な仕事 | 仕事の内容 |
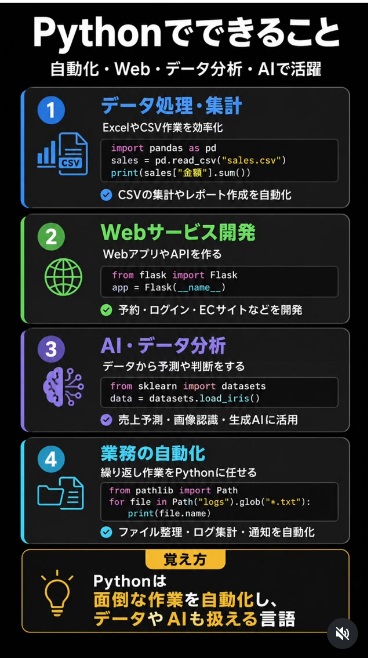
| データ処理・集計 | ExcelやCSV作業を効率化 CSVの集計やレポート作成を自動化 手作業では数時間かかる集計でも、 Pythonを使えば短時間で 終わらせられる |
| Webサービス開発 | WebアプリやAPIを作る 予約・ログイン・ECサイトの開発 サービスの中心部分を作る仕事で、 身につける内容は多いですが、 その分、案件の幅も広がりやすい |
| AI・データ分析 | データから予測や判断をする 売上予測・画像認識・生成AIに活用 |
| 業務の自動化 | 繰返し作業をPythonに任せる ファイル整理・ログ集計・通知 |
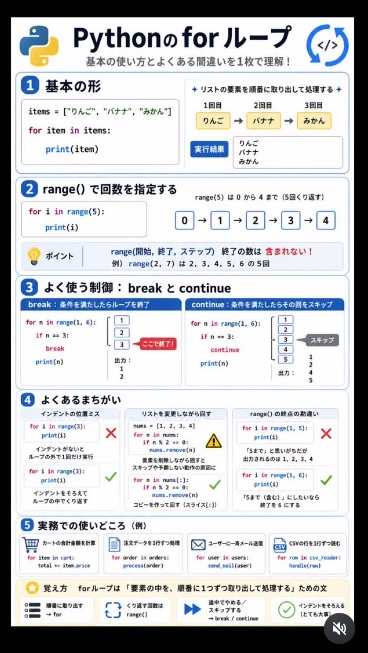
| 基本形 リストの要素を順番に取り出して 処理する | items = [“りんご”, “バナナ”, “みかん”] for item in items: print(fruit) 実行結果 りんご バナナ みかん |
| range() で回数を指定する range(5) は0から4まで (5回くり返す) range(開始,終了、ステップ) 終了の数は含まれない | for i in range(5): print(i) range(5) は0から4まで (5回くり返す) range(2,7) は2,3,4,5,6の5回 |
| よく使う制御 breakとcontinue | break: 条件を満たしたらループを終了 for n in range(1, 6): if n 3: ・・・3番目で終了 break print(n) 実行結果 1,2 continue:条件を満たした回をskip for n in range(1, 6): if n == 3: ・・・3番目をskip continue print(n) 実行結果 1,2,4,5 |
| よくあるまちがい | インデントの位置ミス for i in range(3): print(i) インデントがないと ループの外で1個だけ実行 for i in range(3): print(1) インデントをそろえると ループの中でくり返す リストを変更しながら回す nums [1, 2, 3, 4] for n in nums: if n % 2 == 0: nums.remove(n) 要素を削除しながら回すと スキップや 予期しない動作の原因に nums [1, 2, 3, 4] for n in nums[:]: if n % 2 == 0: nums.remove(n) コピーを作って回す スライス(:)を使用する range() の終点の勘違い for i in range(1, 5): print(1) 「5まで」と思いがちだが 出力されるのは1, 2, 3, 4 for i in range(1, 6); print(1) 「5まで(含む)」にしたいなら 終了を6にする |
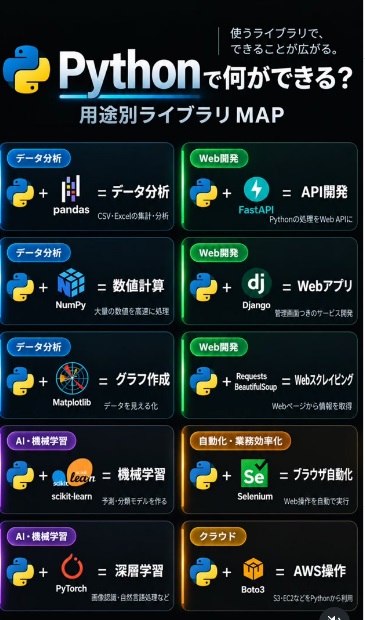
| データ分析 | pandas データ分析 CSV・Excelの集計・分析 NumPy 数値計算 大量の数字を高速処理 Matplotlib グラフ作成 データを見える化 |
| Web開発 | FastAPI API開発 Pythonの処理をWeb APIに Django Webアプリ 普通通りのサービス開発 Requests + BeautifulSoup WEbスクレイピング Webページから情報を取得 |
| AI・機械学習 | scikit-learn 機械学習 予測モデルを作る PyTorch 深層学習 画像認識・自然言語処理など |
| 自動化・業務効率化 | Selenium ブラウザ自動化 Web操作を自動で実行 |
| クラウド | Boto3 AWS操作 S3・EC2などをPythonから利用 Simple Storage Serviceの略 |
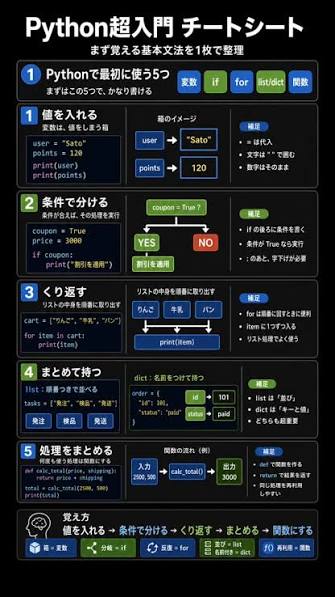
| 変数 | 値を入れる 変数は、値をしまう箱 | user “Sato” points = 120 print(user) print(points) 補足 = は代入 文字は””で囲む 数字はそのまま |
| if | 条件で分ける 条件が合えば、 その処理を実行 | coupon = True price = 3000 if coupon: print(“割引を適用”) 補足 if の後ろに条件を書く 条件がTrue なら実行 :のあとは字下げ |
| for | くり返す リストの中身を順番に取り出す | cart = [“りんご”。“牛乳”、“パン] for item in cart: print(item) 補足 forは順番に回す item に1つずつ入る リスト処理でよく使う |
| list/dict | まとめて持つ list: 順番つきで並べる dict: 名前を付け持つ | tasks = [“発注”,“検品”,“発送”] order ( ”id”: 101, ”status”: “paid” ) 補足: list は「並び」 dict は「キーと値」 どちらも超重要 |
| 関数 | 処理をまとめる 何度も使う処理は関数にする | def calc_total(price, shipping): return = price * shipping total = calc_total (2500, 500) print(total) 補足: def で関数を作る return で結果を返す 同じ処理を再利用しやすい |
macOS(またはLinux)用パッケージマネージャー
コマンドラインツールやアプリケーションのインストール、更新、管理を
非常に簡単に行うことができる(参考URL https://brew.sh/ja/)
macOS(Linux)の機能を補完する
gemでRubyGemsを、brewで依存パッケージをインストールする
“アイコンをドラッグしてインストール…”のようなことをする必要はない
Homebrew Caskでは
macOS関連だけではないソフトウェアもインストールできる
「ターミナル」から以下のコマンドを使用する
/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"続けて、インストールの完了を「ターミナル」で確認する
brew -v
パッケージのインストール
brew install <パッケージ名>
パッケージのアンインストール
brew remove <パッケージ名>
インストール済みパッケージの一覧表示
brew list

パッケージのバージョンアップグレード
全てのパッケージ: brew upgrade
個別のパッケージ: brew upgrade <パッケージ名>
パッケージの検索
brew search <パッケージ名>
Homebrew自体の更新
brew update
更新可能なパッケージの確認
brew outdated
Gitのインストール
brew install git
pythonのインストール
brew install python
WindowsとMacそれぞれの環境に合わせて記述する
・公式サイトからインストーラーをダウンロードする
公式サイト https://www.python.org/downloads/windows/ にアクセス
最新バージョンのPythonを選択する
Download Python 3.x.x のようなボタンを押下し
インストーラー(.exeファイル)をダウンロードする
・インストーラーを実行する
ダウンロードした.exeファイルをダブルクリックして実行する
「Add Python 3.x to PATH」のチェックボックスに必ずチェックを入れる
コマンドプロンプトからpythonコマンドを実行できるようになる
「Install Now」をクリックし、インストール開始
完了すると「Setup was successful」という画面が表示される
「Close」をクリックして終了
・macOSに最初からPythonがプリインストールされている
インストール状態を確認して、インストール作業の可否を判断する
最新版をインストールすると旧版が残る
削除方法を探したが、簡単ではないと分かったので削除せずに放置する
・公式サイトからインストーラーをダウンロードする(推奨)
公式サイト https://www.python.org/downloads/macos/ にアクセス
最新バージョンのPythonを選択する
Download Python 3.x.x のようなボタンを押下し
インストーラー(.pkgファイル)をダウンロードする
・インストーラーを実行する
ダウンロードした.pkgファイルをダブルクリックして実行する
画面の指示に従って、進める
完了すると、「インストールが完了しました」と表示される
・Homebrewを使用する(参照:Homebrewインストール)
Mac用のパッケージマネージャー、
コマンドラインから簡単にソフトウェアをインストール・管理できる
Pythonのインストールが簡単にできるので、お勧めの方法
処理ログ参照
テキスト編集プログラム(メモ帳等)を使って作成する
print("Hello, Python!") ファイル名を「my_program.py」としてローカルPC内に保存する
拡張子「.py」はPythonプログラムを示すもの
・コマンドプロンプトで確認する
スタートメニューで「cmd」と入力し、コマンドプロンプトを起動する
cdコマンドでプログラムファイルが保存されているフォルダを指定する
例として、cd C:\Users\YourName\Documents 等で指定する
Pythonプログラムを実行する
python my_program.py
結果を確認する
Hello, Python! と表示されば、インストール完了
エラーメッセージが表示された場合は、原因を特定する
・エラー表示の場合には、
「Add Python to PATH」にチェックを入れ忘れている可能性がある
一度Pythonをアンインストールし、再度インストールする
・MacでもWindowsと同様に、ターミナルを使って確認する
Finderで「アプリケーション」→「ユーティリティ」→「ターミナル」
または、Spotlight検索で「ターミナル」と入力する
cdコマンドでプログラムファイルが保存されているフォルダを指定する
例として、cd ~/Documents 等で指定する
Pythonプログラムを実行する
python3 my_program.py
結果を確認する
Hello, Python! と表示されば、インストール完了
エラーメッセージが表示された場合は、原因を特定する
・Macの場合、pythonコマンドは古いPython 2.xを指している可能性がある
必ずpython3コマンドで確認する
ターミナル(またはコマンドプロンプト)でコマンドを実行する
・コマンドプロンプトを開く
Win + R を同時に押下、「cmd」と入力し
Enterキー押下

・コマンドを入力する
python –version
・結果の確認
Python 3.11.4 等と表示されれば、インストール済み
表示された数字はバージョン番号(随時アップされます)
その他の文言が表示されれば、インストールされていない
・ターミナルを開く
Cmd + Spaceを同時に押下、Spotlightが開く、ターミナルと入力し、
Enterキー押下

・コマンドを入力する
python3 –version
・結果の確認
Python 3.9.6 などと表示されれば、インストール済み
表示された数字はバージョン番号、2025年8月現在は3.13
command not found のようなエラーが出たら、インストールされていない
・以下のメッセージが表示された場合
Last login: Fri Aug 22 13:10:23 on console
⚫︎⚫︎⚫︎@⚫︎⚫︎⚫︎MacBook-Air ~ % python3 xcode-select: note: No developer tools were found, requesting install. If developer tools are located at a non-default location on disk, use sudo xcode-select --switch path/to/Xcode.app to specify the Xcode that you wish to use for command line developer tools, and cancel the installation dialog. See man xcode-select for more details.
コマンドライン開発ツールのインストールを求められている
Command Line Developer Tools
Python自体は入っているけれど、
それを使うためのツールがまだセットアップされていない状態
・案内に従ってインストールする(推奨)
python3 を実行する
ポップアップメセージに従う
「Command Line Developer Toolsをインストールしますか?」
「インストール」をクリック
数分〜10分ほどで完了する
・手動でインストールする(案内のメッセージが表示されない場合)
ターミナルから入力する
xcode-select –install
Command Line Toolsのインストールが始まる
数分〜10分ほどで完了する
・ツールのインストール後に確認
・コマンドを入力する
python3 –version
・結果の確認
Python 3.10.12 などと表示されれば、インストール済み
表示された数字はバージョン番号(随時アップされます)
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""

演習1(forのネスト)
1から31までの整数を要素とするリスト1と,1から12までの整数を要素とするリスト2を作成します.リスト1とリスト2から値を1つずつ取ってきた時,1の位が一致する値が何組あるかを求めてください.例えば,1と11は,1の位が両方1なので,カウントに入ります.1と1,31と1なども同様です.

期待する出力:38

演習2(辞書の値ソート)
辞書が以下のように定義されています.

dic = {'two':324, 'four':830, 'three':493, 'one':172, 'five':1024}
この時,値で昇順ソートしたと考えた場合のキーの並びを出力してください.

期待する出力:['one', 'two', 'three', 'four', 'five']

演習3(num2freq)
リストが以下のように定義されています.

nums = [1,2,4,3,2,1,5,1]
このリストに対して,要素の出現数を格納した辞書num2freqを作成し,出力してください.これはnum2freq[要素] = 出現数となるような辞書で,例えばnum2freq[1] = 3です.

期待する出力:{1: 3, 2: 2, 4: 1, 3: 1, 5: 1}

演習4(word2freq)
今,文字列が以下のように与えられています.

doc = 'i bought an apple .\ni ate it .\nit is delicious .'
\nは改行記号なので,3つの文が3行に渡って書かれていることになります.
この文章中の単語を用いて,キーとして単語,値として出現数を持つような辞書word2freqを作成し,出力してください.ただし,改行記号は単語に含めないでください.
ヒント:改行記号でsplitしてから空白でsplitすれば,単語に分割できます.

期待する出力:{'i': 2, 'bought': 1, 'an': 1, 'apple': 1, '.': 3, 'ate': 1, 'it': 2, 'is': 1, 'delicious': 1}

演習5(Jaccard係数)
2つの集合A,Bの類似度を計算する方法として,Jaccard係数というものがあります.例えば,文章の類似度の指標として使われています.

Jaccard(A,B)=|A∩B||A∪B|=AとBの積集合の要素数AとBの和集合の要素数
2つのリストが以下のように与えられている時,リストを集合と見なした時のJaccard係数の値を求めてください.

list1 = [12,23,34,45,56,67,78,89]
list2 = [21,32,43,45,65,67,78,98]
期待する出力:0.23076923076923078

"""
#
#
#演習1(forのネスト)
#
print("演習1(forのネスト)")
#
l1 = list(range(1,32))
l2 = list(range(1,13))
#print(l1)
#print(l2)
cnt = 0
for item1 in l1:
  for item2 in l2:
    if item1 % 10 == item2 % 10:
#      print(item1,item2)
      cnt += 1
print(cnt)
#
#演習2(辞書の値ソート)
#
print("演習2(辞書の値ソート)")
#
dic = {'two':324, 'four':830, 'three':493, 'one':172, 'five':1024}
item = list(dic.items())
#print(item)
x = sorted(item, key=lambda x:x[1])
#print(x)
q = [i[0] for i in x]
print(q)
#
#演習3(num2freq)
#
print("演習3(num2freq)")
#
nums = [1,2,4,3,2,1,5,1]
num2freq = {}
for i in nums:
  num2freq[i] = num2freq.get(i, 0) + 1
#  print(num2freq[i])
print(num2freq)
#
#演習4(word2freq)
#
print("演習4(word2freq)")
#
doc = 'i bought an apple .\ni ate it .\nit is delicious .'
word2freq = {}
x1 = doc.split('\n')
#print(x1)
for x in x1:
  words = x.split()
#  print(words)
  for word in words:
    word2freq[word] = word2freq.get(word, 0) + 1
print(word2freq)
#
#演習5(Jaccard係数)
#
print("演習5(Jaccard係数)")
#
list1 = [12,23,34,45,56,67,78,89]
list2 = [21,32,43,45,65,67,78,98]
a = set(list1)
b = set(list2)
inter_set = a.intersection(b)
union_set = a.union(b)
print(len(inter_set) / len(union_set))
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""

46. range()
0から99の100の要素からなるリストを出力してください.

期待する出力:[0,1,2....,99](一部省略)

47. 内包表記
変数にリスト[5,4,3,2,1]を代入し,要素と添字の値(先頭を0とする)を足し合わせた数値を要素に持つリストを新たに作成してください.
内包表記を使うと便利です.

期待する出力:[5,5,5,5,5]

48. 例外処理
下記のように変数が作られています.

a = 0
b = 5
この時,abとbaを出力してください.ただし,ゼロ割りが発生した時にはzero divisionを出力します.
例外処理を用いて書いてみると良いと思います.

期待する出力:0, zero division

49. ビット演算
変数aに10を,変数bに5を代入します.この時,aとbの論理和,論理積,排他的論理和を出力してください.出力形式は問いません.

期待する出力:15 0 15

50. モジュールのインポート
mathモジュールをインポートして,θ=π2の下で,sinθ2+ cosθ2の値を計算してください.

期待する出力:1.0

"""
#
#
#46. range()
#
print("46. range()")
#
i = list(range(100))    #正解
print(i)
#
#47. 内包表記
#
print("47. 内包表記")
#
x = [5,4,3,2,1]
q = [i + item for i, item in enumerate(x)]   #正解
print(q)
#
#48. 例外処理
#
print("48. 例外処理")
#
a = 0
b = 5
try:
  print(a / b)
except ZeroDivisionError:
  print('zero division')
#
try:
  print(b / a)
except ZeroDivisionError:  #正解
  print('zero division')
#
#49. ビット演算
#
print("49. ビット演算")
#
a = 10
b = 5
print(a | b)
print(a & b)
print(a ^ b)   #正解
#
#50. モジュールのインポート
#
print("50. モジュールのインポート")
#
import math            #正解
theta = math.pi / 2
#print(theta)
q = math.sin(theta)**2 + math.cos(theta)**2
print(q)実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""

41. max
変数にリスト[11,2,7,13,5]を代入し,最大値を出力してください.

期待する出力:13

42. min
変数にリスト[11,2,7,13,5]を代入し,最小値を出力してください.

期待する出力:2

43. sum
変数にリスト[11,2,7,13,5]を代入し,総和を出力してください.

期待する出力:38

44. 昇順ソート
変数にリスト[5,3,1,4,2]を格納し,昇順に並び替えたリストを出力してください.

期待する出力:[1,2,3,4,5]

45. ラムダ式
いま,辞書を要素とするリストが次のように与えられています.

li = [{'a': 6, 'b': 7, 'c': 6},
      {'a': 4, 'b': 2, 'c': 3},
      {'a': 1, 'b': 5, 'c': 8}]
このとき,辞書のキーが'b'の値に関して降順になるようにソートしてください.

期待する出力:[{'a': 6, 'b': 7, 'c': 6}, {'a': 1, 'b': 5, 'c': 8}, {'a': 4, 'b': 2, 'c': 3}]

"""
#
#
#41. max
#
print("41. max")
x = [11,2,7,13,5]
print(max(x))
#
#42. mi
#
print("42. min")
x = [11,2,7,13,5]
print(min(x))
#
#43. sum
#
print("43. sum")
x = [11,2,7,13,5]
print(sum(x))
#
#44. 昇順ソート
#
print("44. 昇順ソート")
x = [5,3,1,4,2]
print(sorted(x))
#print(sorted(x,reverse=True))
#
#
#45. ラムダ式
#
print("45. ラムダ式")
li = [{'a': 6, 'b': 7, 'c': 6},
      {'a': 4, 'b': 2, 'c': 3},
      {'a': 1, 'b': 5, 'c': 8}]
print(sorted(li, reverse=True, key=lambda li: li['b'])) #正解実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""

36. 差集合
変数set1に集合{1,2,3,4,5},変数set2に集合{3,4,5,6,7}を代入し,差集合を出力してください.

期待する出力:{1,2}

37. 型の確認
3つの変数に以下のように代入したコードがあります.各変数の型を出力してください.出力形式は問いません.

data1 = {'A':1, 'B':2}
data2 = "hoge"
data3 = {1,2,3,4,5}
期待する出力:<class 'dict'> <class 'str'> <class 'set'>

38. strip
文字列'This is sentence .\n'の改行記号を消したものを出力してください.

期待する出力:This is sentence .

39. split
変数に文字列'C C++ // python java'を代入し,この文字列を空白で区切った後のリストを出力してください,また,同じことを'/'でも行い,出力してください.

期待する出力:['C', 'C++', '//', 'python', 'java'],['C C++ ', '', ' python java']

40. join
変数にリスト['This', 'is', 'a', 'sentence']を代入し,これらを空白区切で結合した文字列を出力してください.

期待する出力:This is a sentence

"""
#
#
#36. 差集合
#
print("36. 差集合")
x = {1,2,3,4,5}
y = {3,4,5,6,7}
print(x - y)
#
#37. 型の確認
#
print("37. 型の確認")
data1 = {'A':1, 'B':2}
data2 = "hoge"
data3 = {1,2,3,4,5}
print(type(data1),type(data2),type(data3))  #正解
"""
#
#  str    文字列
#  int    整数
#  float   浮動小数点
#  bool    ブール(truem,false)
# datetime  日付
# list    配列    [ ]
# tuple    タプル  ( )
#  dictionry  辞書    { }
#  set     集合    { }
"""
#
#38. strip
#
print("38. strip")
x = 'This is sentence .\n'
print(x.rstrip())    #正解
#
#39. split
#
print("39. split")
x = 'C C++ // python java'
print(x.split( ))
print(x.split('/'))   #正解
#
#40. join
#
print("40. join")
x = ['This', 'is', 'a', 'sentence']
print(' '.join(x))    #正解
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""

31. スライス2
変数に文字列'understand'を代入し,先頭を0番目として,奇数番目の文字列だけを取り出した文字列を出力してください.

期待する出力:nesad

32. スライス3
変数にリスト[1,2,3,4,5]を格納して,これを逆順に出力してください.

期待する出力:[5,4,3,2,1]

33. 集合
変数にリスト[1,1,2,3,3,4,5]を代入し,このリストを集合に変換して出力してください.

期待する出力:{1,2,3,4,5}

34. 積集合
変数set1に集合{1,2,3,4,5},変数set2に集合{3,4,5,6,7}を代入し,積集合を出力してください.

期待する出力:{3,4,5}

35. 和集合
変数set1に集合{1,2,3,4,5},変数set2に集合{3,4,5,6,7}を代入し,和集合を出力してください.

期待する出力:{1,2,3,4,5,6,7}

"""
#
#
#31. スライス2
#
print("31. スライス2")
x = 'understand'
print(x[1::2])    #正解
#
#32. スライス3
#
print("32. スライス3")
x = [1,2,3,4,5]
print(x[::-1])  #正解
#
#33. 集合
#
print("33. 集合")
x = {1,1,2,3,3,4,5}
print(x)
#
x = [1,1,2,3,3,4,5]  #正解
print(set(x))
#
"""
 角[ ] 配列
 波{ } 集合
"""
#
#
#34. 積集合
#
print("34. 積集合")
x = {1,2,3,4,5}
y = {3,4,5,6,7}
print(x & y)
#
#35. 和集合
#
print("35. 和集合")
x = {1,2,3,4,5}
y = {3,4,5,6,7}
print(x | y)実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""

26. 辞書(keys)
変数に,値の組みとして{'A':1, 'B':2, 'C':3, 'D':4, 'E':5}を持つ辞書を格納して,キーを要素としたリストを作成し,出力してください.

期待する出力:['A', 'B', 'C', 'D', 'E']

27. 辞書(values)
変数に,値の組みとして{'A':1, 'B':2, 'C':3, 'D':4, 'E':5}を持つ辞書を格納して,値(バリュー)を要素としたリストを作成し,出力してください.

期待する出力:[1,2,3,4,5]

28. 辞書(items)
変数に,値の組みとして{'A':1, 'B':2, 'C':3, 'D':4, 'E':5}を持つ辞書を格納して,キーと値(バリュー)の組みのタプルを要素としたリストを作成し,出力してください.

期待する出力:[('A', 1), ('B', 2), ('C', 3), ('D', 4), ('E', 5)]

29. 辞書(キーの存在確認)
今,以下のように辞書が作成済みです.

d = {'apple':10, 'grape':20, 'orange':30}
この辞書に対して,'apple'というキーが存在するかを確認し,存在しなければ,'apple'というキーに対して-1という値を追加してください.また,同様のことを'pineapple'でも行なってください.その後,最終的な辞書を出力してください.

期待する出力:{'apple': 10, 'grape': 20, 'orange': 30, 'pineapple': -1}

30. スライス1
変数に文字列'training'を代入し,先頭を0番目として,1番目から4番目までを取り出して出力してください.

期待する出力:rain

"""
#
#
#26. 辞書(keys)
#
print("26. 辞書(keys)")
x = {'A':1, 'B':2, 'C':3, 'D':4, 'E':5}
print(list(x.keys()))   #正解
#
#27. 辞書(values)
#
print("27. 辞書(values)")
x = {'A':1, 'B':2, 'C':3, 'D':4, 'E':5}
print(list(x.values()))  #正解
#
#28. 辞書(items)
#
print("28. 辞書(items)")
x = {'A':1, 'B':2, 'C':3, 'D':4, 'E':5}
print(list(x.items()))  #正解
#
#29. 辞書(キーの存在確認)
#
print("29. 辞書(キーの存在確認)")
d = {'apple':10, 'grape':20, 'orange':30}
d['apple'] = d.get('apple',-1)    #正解
d['pineapple'] = d.get('pineapple',-1)
print(d)
#
#30. スライス1
#
print("30. スライス1")
x = 'training'
print(x[1:5])     #正解
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""

21. リスト(forによる捜査, enumerate)
変数に[1,2,3,4,5]の5つの要素を持つリストを格納して,添え字が偶数番目の要素だけ出力してください.出力形式は問いません.ただし,先頭の添え字を0番目とします.

期待する出力:1 3 5

22. リスト(len)
変数にリスト[11,22,33,44,55,66]を代入し,リストの要素数を出力してください.

期待する出力:6

23. リスト,if(存在確認)
リスト[11,22,33,44,55]に,値44が存在するかどうかをifを用いて判定してください.存在すればTrue,そうでなければFalseを出力します.

期待する出力:True

24. タプル,リストの負のindex
変数に[1,2,3,4,5]の5つの要素を持つリストを格納して,リストの先頭の要素と末尾の要素をタプルとして格納し,出力してください.

期待する出力:(1, 5)

25. 辞書
変数に,値の組みとして{'A':1, 'B':2, 'C':3, 'D':4, 'E':5}を持つ辞書を格納して,出力してください.

期待する出力:{'A': 1, 'B': 2, 'C': 3, 'D': 4, 'E': 5}

"""
#
#
#21. リスト(forによる捜査, enumerate)
#
print("21. リスト(forによる捜査, enumerate)")
x = [1,2,3,4,5]
for i, sfix in enumerate(x):   #正解
  if i % 2 == 0:
    print(sfix)
#
#22. リスト(len)
#
print("22. リスト(len))")
x = [11,22,33,44,55,66]
print(len(x))
#
#23. リスト,if(存在確認)
#
print("23. リスト,if(存在確認)")
x = [11,22,33,44,55]
if 44 in x:             #正解
  print('true')
else:
  print('false')
#
#24. タプル,リストの負のindex
#
print("24. タプル,リストの負のindex")
x = [1,2,3,4,5]
y = (x[0], x[-1])       #正解
print(y)
#
#25. 辞書
#
print("25. 辞書")
x = {'A':1, 'B':2, 'C':3, 'D':4, 'E':5}
print(x)実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""

16. リスト
変数にリスト[1,2,3,4,5]を代入し,(先頭を0番目として)3番目の要素を出力してください.

期待する出力:4

17. リスト(結合)
変数li1に[1,2,3]のリストを代入,変数li2に[4,5]のリストを代入し,2つのリストを結合して出力してください.

期待する出力:[1,2,3,4,5]

18. リスト(append)
変数にリスト[1,2,3,4,5]を代入し,このリストの末尾に6,7を1つずつ順番に追加してください.その後,最終的なリストを出力してください.

期待する出力:[1,2,3,4,5,6,7]

19. リスト(insert)
変数にリスト[1,2,3,4,5]を作成し,先頭を0番目としたときに,0番目と1番目の間に100を挿入してください.

期待する出力:[1,100,2,3,4,5]

20. リスト(forによる捜査)
変数に[1,2,3,4,5]の5つの要素を持つリストを格納して,偶数の要素だけ出力してください.出力形式は問いません.

期待する出力:2 4

"""
#
#
#16. リスト
#
print("16. リスト")
x = [1,2,3,4,5]
print(x[3])
#
#17. リスト(結合)
#
print("17. リスト(結合)")
li1 = [1,2,3]
li2 = [4,5]
print(li1 + li2)
#
#18. リスト(append)
#
print("18. リスト(append)")
x = [1,2,3,4,5]
x.append(6)
x.append(7)
print(x)
#
x = [1,2,3,4,5]
x.extend([6,7])
print(x)
#
#19. リスト(insert)
#
print("19. リスト(insert)")
x = [1,2,3,4,5]
x.insert(1, 100)
print(x)
#
#20. リスト(forによる捜査)
#
print("20. リスト(forによる捜査)")
x = [1,2,3,4,5]
for i in x:          #正解
  if i % 2 == 0:
    print (i)
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""

11. 文字列(replace)
変数に文字列'some1'を代入し,この文字列中の1をoneに変換してください.

期待する出力:someone

12. 文字列(lower)
変数に文字列'This Is A Sentence .'を代入し,この文字列を全て小文字に変換してください.

期待する出力:this is a sentence .

13. 文字列(upper)
変数に文字列'This Is A Sentence .'を代入し,この文字列を全て大文字に変換してください.

期待する出力:THIS IS A SENTENCE .

14. 文字列(文字数)
変数に文字列'How many characters?'を代入し,この文字列の文字数を出力してください.空白も含めるものとします.

期待する出力:20

15. 文字列 → 数値
変数aに文字列'34'を代入し,変数bに文字列'43'を代入し,これらを数字と見なした時の和を出力してください.

期待する出力:77

"""
#
#
#11. 文字列(replace)
#
print("11. 文字列(replace)")
x = 'some1'
print(x.replace('1', 'one'))
#
#12. 文字列(lower)
#
print("12. 文字列(lower)")
x = 'This Is A Sentence .'
print(x.lower())
#
#13. 文字列(upper)
#
print("13. 文字列(upper)")
x = 'This Is A Sentence .'
print(x.upper())
#
#14. 文字列(文字数)
#
print("14. 文字列(文字数)")
x = 'How many characters?'
print(len(x))
#
#15. 文字列 → 数値
#
print("15. 文字列 → 数値")
a = '34'
b = '43'
print(int(a)+ int(b))実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""
6. if,比較演算子<, >
変数aに5を代入,変数bに10を代入し,aとbのうち大きい方を出力してください.

期待する出力:10

7. 比較演算子==, bool
変数aに5を代入し,aが偶数ならTrue,そうでなければFalseを出力してください.(条件式をそのままprintすれば良いです.)

期待する出力:False

8. 文字列(ランダムアクセス)
変数に,'python'という文字列を代入し,先頭の文字を0番目として2番目の文字を出力してください.

期待する出力:t

9. 文字列(結合)
'py'と'thon'という2つの文字列をそれぞれ変数に代入し,結合したものを出力してください.

期待する出力:python

10. 文字列(format)
変数aに5を,変数bに3を代入し,これらの変数を用いて'5%3=2'という文字列を出力してください.

期待する出力:5%2=2

"""
#
#
#6. if,比較演算子<, >
#
print("6. if,比較演算子<, >")
a = 5
b = 10
if a > b:
  print(a)
else:
  print(b)
#
#7. 比較演算子==, bool
#
print("7. 比較演算子==, bool")
a = 5
##print (a % 2 == 0)  正解
#
print('odd'if a % 2 == 0 else 'False')
#
#8. 文字列(ランダムアクセス)
#
print("8. 文字列(ランダムアクセス)")
x = 'python'
print(x[2])
#
#9. 文字列(結合)
#
print("9. 文字列(結合)")
x = 'py'
y = 'thon'
#x += y
##print(x + y) 正解
#
x += y
print(x)
#
#10. 文字列(format)
#
print("10. 文字列(format)")
a = 5
b = 3
#q = "{}%{}={}".format(a, b, a%b)  正解
#print(q)
#
print("{:d}%{:d}={:d}".format(a, b, a%b))
# 別解
print(f'{a}%{b}={a%b}')実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
"""
1. 変数
xという変数に2を代入し,それを3倍した数を出力してください.

期待する出力:6

2. swap
変数aに100を代入し,変数bに200を代入します.その後,両者の値を入れ替えて,aに200,bに100が代入されているようにしてください.出力としてはaとbを出力してください.出力形式は問いませんが,print(a,b)とすると,空白区切で出力できます.

期待する出力の一例:200 100

3. 四則演算+α
変数aに10を代入,変数bに2を代入し,aとbの和,差,積,商を出力してください.出力形式は問いません.また,商の値が小数か整数かは問いません.

期待する出力の一例:12 8 20 5.0

4. 余り
変数aに5を代入,変数bに3を代入し,aをbで割った時の余りを求めてください.

期待する出力:2

5. べき乗
変数aに5を代入,変数bに10を代入し,aのb乗,つまりabを出力してください.

期待する出力:9765625

"""
#
#1. 変数
#
print("1. 変数")
x= 2
print(x*3)
#
#2. swap
#
print("2. swap")
a=100
b=200
a,b=b,a
print(a, b)
#
#3. 四則演算+α
#
print("3. 四則演算+α")
a=10
b=2
print(a+b, a-b, a*b, a/b)
#
#4. 余り
#
print("4. 余り")
a=5
b=3
print(a%b)
#
#5. べき乗
#
print("5. べき乗")
a=5
b=10
print(a**b)
#実行例は、「saka.mokumoku」の「Google Colabotory」環境に保存してある
「項目番号」が名前の先頭に付与してある
| 08 | |||
| 07 | if __name__ == “__main__” | 2024-12-31 | Pythonプログラム エントリーポイント設定 |
| 06 | オブジェクト指向とPython | 2024-11-05 | クラスの作成。継承 インスタンス作成 |
| 05 | 辞書とオブジェクト指向 | 2024-11-05 | 辞書の作成、クラスの作成 |
| 04 | Pandas DataFrame | 2024-10-29 | Pandas DataFrame 作成・追加・削除 |
| 03 | 可変長引数 | 2019-06-21 | 任意の値を引数にセット 対応した結果を得る |
| 02 | Map関数 | 2023-10-19 | 簡易的にリストで内容を渡す |
| 01 | Tkinter | 2023-10-19 | 画面作成用のライブラリーGUI使用のエラー発生 |
pythonの練習問題を掲載しているサイトを使用する
練習問題55本ノック【問題と解答】
| 練習問題(01~05) | 1. 変数 2. swap 3. 四則演算 4. 余り 5. べき乗 |
| 練習問題(06~10) | 6. if,比較演算子<, > 7. 比較演算子==, bool 8. 文字列(ランダムアクセス) 9. 文字列(結合) 10. 文字列(format) |
| 練習問題(11~15) | 11. 文字列(replace) 12. 文字列(lower) 13. 文字列(upper) 14. 文字列(文字数) 15. 文字列 → 数値 |
| 練習問題(16~20) | 16. リスト 17. リスト(結合) 18. リスト(append) 19. リスト(insert) 20. リスト(forによる捜査) |
| 練習問題(21~25) | 21. リスト(forによる捜査, enumerate) 22. リスト(len) 23. リスト,if(存在確認) 24. タプル,リストの負の添え字 25. 辞書 |
| 練習問題(26~30) | 26. 辞書(keys) 27. 辞書(values) 28. 辞書(items) 29. 辞書(キーの存在確認) 30. スライス1 |
| 練習問題(31~35) | 31. スライス2 32. スライス3 33. 集合 34. 積集合 35. 和集合 |
| 練習問題(36~40) | 36. 差集合 37. 型の確認 38. strip 39. split 40. join |
| 練習問題(41~45) | 41. max 42. min 43. sum 44. 昇順ソート 45. ラムダ式 |
| 練習問題(46~50) | 46. range() 47. 内包表記 48. 例外処理 49. ビット演算 50. モジュールのインポート |
| 練習問題(51~55) | 演習1(forのネスト) 演習2(辞書の値ソート) 演習3(num2freq) 演習4(word2freq) 演習5(Jaccard係数) |
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
アンダースコアに惑わされずに読めば
「__name__に格納されている値が'__main__'という文字列であれば
この条件文以降の処理を実行するという単なるif文
Pythonのサンプルコードにおまじないのように書かれている
このif文の意味と使い方を説明する
# mymodule.py
print("mymoduleが起動されました")

# thenの部分は直接起動時、elseの部分はimportされた時
if __name__ == "__main__":
    print("このコードはmymoduleを直接実行したときに実行されます",__name__)
else:
  print("このコードはmymoduleをimportしたときに実行されます",__name__)
上記コードの説明
import mymoduleの場合
トップレベルの部分が処理され以下の表示がされる
”mymoduleが起動されました”
if __name__ == “__main__”:の
__name__ は「main」なのでelse処理が実行される
”このコードはmymoduleをimportしたときに実行されます”
mymoduleを直接実行(mymodule.pyの起動)した場合
トップレベルの部分が処理され以下の表示がされる
”mymoduleが起動されました”
if __name__ == “__main__”:の
__name__ は「__main__」なのでthen処理が実行される
”このコードはmymoduleを直接実行したときに実行されます”
# calculator.py
def add(x, y):
    return x + y

def subtract(x, y):
    return x - y

if __name__ == "__main__":
    print(add(3, 4))
    print(subtract(10, 5))
上記コードの説明
直接実行すると、足し算と引き算の結果が出力される
上記コードの実行結果
mymoduleが起動されました
このコードはmymoduleを直接実行したときに実行されます
*** __main__
7
5
# calculator.py
def add(x, y):
    return x + y

def subtract(x, y):
    return x - y

if __name__ == "__main__":
    print(add(3, 4))
    print(subtract(10, 5))

import main
print(add(3,4))
上記コードの説明
importすると、足し算と引き算の結果が出力される
上記コードの実行結果
****** import 処理
mymoduleが起動されました
このコードはmymoduleをimportしたときに実行されます
+++ main
*******
import 処理
7
7
| Java | Python | |
| ソースコードの記述スタイル | 変数の宣言時に型を示す必要があるなど、明示的な構文を採用している | 変数の宣言時に型を示す必要がないなど、簡潔な構文を採用している |
| エントリーポイント(プログラムの実行開始点)の実装方法 | 標準で用意されている「main」メソッド(処理)を使う | 「if __name__ == “__main__”」という特殊な「if」条件文を使う |
| 機能の実装方法 | クラス(変数とメソッドをまとめた部品の設計図)を使ってプログラムを組み立てる「オブジェクト指向」の言語 | モジュール(追加機能群)を使って自由な設計でプログラムを組み立てる言語 |
| 習得しやすさ | プログラミング初心者にとってとっつきにくい部分がある | プログラミング初心者でもとっつきやすい |
Javaでmainメソッドを宣言する
非常に明確に定義された単一のエントリーポイントを持っている
mainメソッドは、プログラムが最初に実行される場所
「public static void main(String[] args)」というフレーズが冗長に映る
例としてmainメソッドを「HelloWorld」クラスに格納する
mainメソッドの予期しない実行を防ぐことができる
Javaは構造や制御を明示することを重視しており、
この厳格さがセキュリティ強化につながっている
public class HelloWorld {
  public static void main(String[] args){
    System.out.print("Hello World");
  }
}
public static void main(String[] args)はJavaの実行に必須のメソッド
public・・・どこからでも参照可能
static・・・インスタンス可(new)しなくても外部から使用可能
void・・・・戻り値なし
main・・・・メソッド名
String[]・・引数をString型の配列で受け取る
args・・・・引数名の複数形でargumentsの略省
String[] argsはプログラム起動時に指定する値(コマンドライン引数)
引数名argsは、慣習的にargsが使われる、別の名前でも可
JavaはC言語の後継であり、C言語の慣習を受け継いでいるため
C言語で使われている引数名
argc(argument count(引数の個数))
argv(argument vector(引数の配列))
Java 21(2023/9/19にリリース)で
記述の一部を省略できるようになり、改善されている
mainメソッドの引数を省略できる
mainメソッドがpublicじゃなくてもよくなる
書かなくてよさそうなものを書かずにすむのですっきりする
mainメソッドをprivateにすることはできない、protectedは可能
Pythonではエントリーポイントの概念は無い
スクリプトの先頭から順にコードが実行される
if name == “main“: という条件文を使うことで
直接実行された場合にのみ実行されるコードを記述することができる
if __name__ == “__main__”について
__name__・・・実行されているモジュール名を指す項目名
モジュールが直接実行された時には「__main__」とセットされる
モジュールがimportされた時には「mymodule」とセットされる
if __name__ == “__main__”以下の部分はimportされただけでは動かない
__name__の詳しい使い方については
「Work Shop」の「if __name__ == “__main__”」を参照
言語の設計哲学
Java・・・大規模なシステム開発を想定、プログラム構造を明確にする
Python・・スクリプト言語として誕生、柔軟性と生産性を重視する
静的型付けと動的型付け
Java・・・静的型付け言語、コンパイル時に型チェックされる厳密な構造
Python・・動的型付け言語、実行時に型が決定される柔軟な構造
Pythonで「import」命令でPythonノジュールを読み込むと
読み込んだタイミングで、トップレベルにある命令が実行される
関数定義(def)された部分は動かない
通常のプログラム部分から動き出す
攻撃者は悪意のある命令をトップレベルに記述し
このファイルを呼び出すよう、他人に勧める
対応策
数多くのユーザの目に触れたであろうファイルをimportする
ファイルの中身は多くのユーザが認めた結果と思えば良い
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
# 辞書
koizumi = {"name":"小泉","address":"宮城県","email":"info@aaa.bbb"}
# print(koizumi)
miyajima = {"name":"宮嶋","address":"宮城県","email":"miyajima@aaa.bbb"}
# print(miyajima)

print(koizumi["name"])
print(miyajima["name"]) オブジェクトとは、
データ(属性)とそれを操作する関数(メソッド)をカプセル化したもの
猫という「オブジェクト:Object」は
白くて尻尾があるという「属性:Property」
手足が4本で歩くという「メソッド:Method」
クラスという仕組みがある
クラスには、オブジェクトを作る際のデータやメソッドを定義する
オブジェクトの設計図である
オブジェクトを作る際には、必ずクラス(型)を指定する必要がある
指定したクラスに定義されたデータとメソッドがオブジェクトに備わる
あるクラスのオブジェクトを作る場合に、
そのオブジェクトのことをインスタンス(実例)という
インスタンスをオブジェクトと同じ意味と考えて良い
class Profile:
  def __init__(self,name,address,email):
    self.name = name
    self.address = address
    self.email = email
  def print(self):
    print(self.name)
    print(self.address)
    print(self.email)
  def printX(self):
    print("X")

koizumi = Profile("小泉","宮城県","info@aaa.bbb")

print(koizumi.name)
print(koizumi.address)
print(koizumi.email)実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
オブジェクトとは、
データ(属性)とそれを操作する関数(メソッド)をカプセル化したもの
猫という「オブジェクト:Object」は
白くて尻尾があるという「属性:Property」
手足が4本で歩くという「メソッド:Method」
オブジェクト指向では、クラスというものをプログラムとして記述しておく
オブジェクトを使いたいときに、Pythonの文法を使って、
クラスからオブジェクトを作り出す
作ったオブジェクトのことを「インスタンス(実体:Instance)」と言う
クラスからオブジェクトを作り出す操作のことを、
「実体化する」とか「インスタンスを作る」と言う
クラスとオブジェクトは、1対多の関係
クラスを作成しておけば、オブジェクトを幾つでも作成できる
猫の紹介文のテンプレートが「クラス」
同じテンプレートに違う内容を記入することで、各猫の紹介文を作成する
各猫が「インスタンス」で、
猫の紹介文を作成することを「インスタンス化」という
# クラスの定義
class Neko:
  def __init__(self, breed, color, tail, neko_skill):
    self.breed = breed        # 猫種
    self.color = color # 毛の色
    self.tail = tail   # しっぽの有無
    self.neko_skill = neko_skill # ねこ技を設定

  # 属性に対して操作を行うメソッドの定義
  def hissatsu(self):
    print(f'{self.breed}の必殺技{self.neko_skill}!')

neko1 = Neko('マンチカン', '真っ白', '長い', 'ネコパンチ')
neko2 = Neko('スコティッシュフォールド', '三毛猫', 'ふさふさ', 'ネコキック')

# 属性の確認
print(neko1.color)
print(neko2.tail)

# メソッドの確認
neko1.hissatsu()
neko2.hissatsu()
__init__() を使用する
例として def __init__(self, breed, color, tail, neko_skill):
インスタンスが作成された直後に、初期状態を設定する
特有のデータ(属性)を割り当てる
同じクラスの異なるインスタンスが異なる値を持つことができる
selfの使用 特定のインスタンスの属性やメソッドにアクセスする
例として self.breedはそのインスタンスの breed 属性を指す
例として self を使ってメソッドを呼び出すことにより、
そのインスタンスのコンテキスト内でメソッドが実行される
メソッドがそのインスタンスのデータを操作できるようになる
class Koneko(Neko):
    def __init__(self, color, tail, name, neko_skill):
        super().__init__('マンチカン', color, tail, neko_skill)
        self.name = name

    # hissatsuメソッドをオーバーライド
    def hissatsu(self):
        print(f'{self.color}色の赤ちゃんマンチカンの必殺技{self.neko_skill}!')

    # 新しいメソッド(飼い主にごあいさつ)の追加
    def say_hello(self):
        print(f'はじめまして。ワタシの名前は{self.name}だにゃ。')

koneko = Koneko('オフホワイト', '短い', 'しろねこ', 'ねこじゃらし攻撃')

#
print(koneko.tail)
print(koneko.breed)

#
koneko.hissatsu()
koneko.say_hello()
super().initを使用する
親のクラスを呼び出して使用する
クラスも継承ということを行うことができる
継承元のクラスを親クラス、継承後のクラスを子クラスという
クラスを継承することで、
親クラスの特徴を持ちつつ子クラスに追加の属性を与えることができる
メソッドを上書きしたり、追加することもできる
継承・オーバーライドの際にも self が一役担う
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
リスト、ディクショナリ、NumPyのndarray、CSVファイル等の
ファイルに格納された情報をDataFrameに取り込む
pd.DataFrame(data = 格納するデータ, index = 行名, columns = 列名)
(1)リストからの作成
リストに文字列を設定し、引数として渡す
import pandas as pd
list1=["a1","a2","a3"]
pd.DataFrame(data=list1)
(2)NumPyで作成した配列から、DataFrameを作成する
import numpy as np
arr1 = np.array([[1,2,3], [21,22,23], [31,32,33]])
pd.DataFrame(data=arr1)
(3)辞書からDataFrameを作成する
辞書のキーと合わせて、列単位でデータを設定していく
dict1=dict(Row1=[1,21,31], Row2=[2,22,32], Row3=[3,23,33])
pd.DataFrame(data=dict1)
(4)インデックスや列名を指定してDataFrameを作成する
list1に3行3列のリスト、引数dataにlist1を設定する
index1にインデックス、引数indexにindex1を渡す
columns1に列名、引数columnsにリストcolumns1を渡す
list1=[[1,2,3], [21,22,23], [31,32,33]]
index1 = ["Row1", "Row2", "Row3"]
columns1 =["Col1", "Col2", "Col3"]
pd.DataFrame(data=list1, index=index1, columns=columns1) (1)行を追加する
最初にデータを準備する
list2 = [["P001", "iPhone 8 64GB", 85000],
         ["P002", "iPhone X 256GB", 130000],
         ["P003", "iPhone SE 32GB", 37000]]
columns2 = ["Product ID", "Product Name", "Price (JPY)"]
df1 = pd.DataFrame(data=list2, columns=columns2)
df1
追加するデータ
df2 = pd.DataFrame(data = [["P004", "iPhone 7 32GB", 10000]],
                   columns = columns2)
df2
追加処理
True・・・index番号を振り直す
False・・・index番号はそのまま残る
axis=0・・・行(index)を対象とする
axis=1・・・列(columns)を対象とする
df1 = pd.concat([df1, df2], ignore_index=True, axis=0)
df1
df1 = pd.concat([df1, df2], ignore_index=False, axis=0)
df1(2)列を追加する
注意点は、追加する行の数を合わせること
df1["Screen Size (in.)"] = [4.7, 5.8, 4, 4.7]
df1
(3)行を削除する
引数inplaceが必要
True・・・実行結果が保存され置き換わる
False・・・実行結果が保存されない
df1.drop([2, 3], inplace = True)
df1
(4)列を削除する
axis=0・・・行(index)を対象とする
axis=1・・・列(columns)を対象とする
df1.drop("Screen Size (in.)",axis=1,inplace=True)
df1| デジタルスキル標準 ver.1.2 IPA & METI | 2024-07 |
| スッキリわかるPython入門 | PDF(375ページ) | 2020-09-25 |
| スッキリわかるPython入門 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 0 |
| 0 | 済 | 済 | 済 | 済 | 済 | 済 | 済 | 済 | 済 | 済 |
| 10 | 済 | 済 | 済 | 済 | 済 | |||||
| 360 | 済 | 済 | 済 | 済 | 済 | |||||
| 370 | 済 | 済 | 済 | 済 | 済 | 済 |
| Python 学習教材 | 初心者向け お勧め PDF(309ページ) | 筑波大学システム情報系 教材 「Python ゼロからはじめる プログラミング」 翔泳社 2,068円 |
| Python 学習教材 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 0 |
| 0 | ||||||||||
| 10 | ||||||||||
| 100 | ||||||||||
| 200 | ||||||||||
| 300 |
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
map関数を使うと
煩雑な処理をできるだけ少ない記述量で実現させられる
シーケンスの構成要素すべてに対して、ある関数の処理を行わせる
シーケンスとはオブジェクトを順番に処理するためのデータ構造
複数ある値をひとかたまりとして格納した型のことを言う
リストなどのオブジェクトに含まれる各要素に対して
何かしらの変換を加えて別のオブジェクトを生成させることができる
リスト処理で使われる例
「number1=〇〇」「number2=〇〇」「number3=〇〇」の変数は
リストを使って「number_list=[〇〇,〇〇,〇〇,・・・」と書換える
sample1_list = list(range(5))
def multi(x):
    y = x*2
    return y
sample2_list = map(multi, sample1_list)
print(list(sample2_list))
<その1の説明>
Xの値を2倍にしてyにセットする関数(multi)を用意する
list(range(5))で0〜4までの値を(sample1_list)にセットする
map関数の引数に(sample1_list)を使って0〜4を渡し
(sample2_list)に(multi)関数の結果を返す
sample1_list = list(range(5))
sample2_list = map(lambda y: y*2, sample1_list)
print(list(sample2_list))
<その2の説明>
def文によって関数定義をせずに
map関数の第一引数をlambda式で指定する
lambda(ラムダ)とはある処理に名前を付けずに定義したもの
シンプルな処理であればわざわざ関数定義をせずにlambda式で表現する
ある特定の処理を一度しか行わない場合
ごく限られた範囲でしか使わない場合
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある DeskTopアプリの部品を作成する(アプリ全体の作成ではない)
PythonやRubyなどのGUI作成を支援するための標準ライブラリ
シンプルで使いやすく、プログラミング初心者でも実装しやすい
TKはTool Kitの略
Tkinterを使用すると、
ボタン・メニュー・テキストボックス等のウィンドウを簡単に作成できる
Pythonの標準ライブラリーのため導入作業は不要
import tkinter
import tkinter.messagebox

def say_helloWorld():
    tkinter.messagebox.showinfo(title="Say",message="Hello, World!")

root = tkinter.Tk()
button = tkinter.Button(root,text="Click me!",command=say_helloWorld)
button.pack()

root.mainloop() 最初にoutputエリアに「Click me!」とボックスが表示される、クリックする
次に「Hello, World!」と「OK」ボタンが表示される、「OK」を押して元へ戻る
実行環境にはモニターデバイスの接続が必須
Google Colabではエラーになるので注意する

import tkinter
import tkinter.messagebox
def func_msg():
    tkinter.messagebox.showinfo(title="Say",message="Hello, World!")
root = tkinter.Tk()

# Button
button = tkinter.Button(root,text="Button",command=func_msg)
button.pack()

root.mainloop()
import tkinter
root = tkinter.Tk()
# Canvas
canvas = tkinter.Canvas(root,width=50,height=50)
canvas.pack()
root.mainloop()import tkinter
root = tkinter.Tk()
# CheckButton
var = tkinter.IntVar()
check_button = tkinter.Checkbutton(root,text="CheckButton",variable=var)
check_button.pack()
root.mainloop()import tkinter
root = tkinter.Tk()
# Entry
entry = tkinter.Entry(root)
entry.pack()
root.mainloop()import tkinter
root = tkinter.Tk()
# Text
entry = tkinter.Text(root)
entry.pack()
root.mainloop()import tkinter
root = tkinter.Tk()
# Frame
frame = tkinter.Frame(root, width=200, height=100,borderwidth=10)
frame.pack()
root.mainloop()import tkinter
root = tkinter.Tk()
# Label
label = tkinter.Label(root,text="Label Name")
label.pack()
root.mainloop()import tkinter
root = tkinter.Tk()
# ListBox
list_box = tkinter.Listbox(root)
list_box.insert(1,"Item_1")
list_box.pack()
root.mainloop()import tkinter
root = tkinter.Tk()
file_name = tkinter.Menu(root)
# Menu
menu = tkinter.Menu(root)
root.config(menu=menu)
file_menu = tkinter.Menu(menu)
menu.add_cascade(label="File",menu=file_name)
root.mainloop()import tkinter
root = tkinter.Tk()
# RadioButton
var = tkinter.IntVar()
radio_Button = tkinter.Radiobutton(root,text="Option 1" , variable=var,value=1)
radio_Button.pack()
root.mainloop()import tkinter
root = tkinter.Tk()
# ScrollBar
scroll_bar = tkinter.Scrollbar(root)
scroll_bar.pack(side=tkinter.RIGHT,fill=tkinter.Y)
root.mainloop()import tkinter
root = tkinter.Tk()
# TopLevel
top = tkinter.Toplevel()
top.title("New Widow")
root.mainloop()import tkinter
import tkinter.ttk as ttk
root = tkinter.Tk()
# ComboBox
comboBox = ttk.Combobox(root,value=["apple","orange","remon"])
comboBox.pack()
root.mainloop() ・range命令に出会う
数字のリストを作成したり、連番を生成してfor文で利用する
便利な命令だと分かる
・heap構造に出会う
最も大きな数値を求めるのに有効なツリー構造だと分かる
・再帰処理に出会う
関数の中から自分自身を呼び出し、類似な処理を繰り返す
最初は全然処理内容がトレースできず四苦八苦した

眺めるだけではトレースできないと分かり、print文を挿入して解析する
・Pythonでの変数の扱いルールに出会う
関数の中で使われる変数はグローバル変数ではなくローカル変数
引数として渡された値だけで処理を組み立てている
同じ項目名が使えるのは、都度新しいプログラムが読込まれている
※無限ループはメモリー不足になるとの注意が多く見られる
<ルール>
関数内で参照されるだけの変数は暗黙的にグローバルとなる
関数の本体のどこかで値が変数に代入されたなら
明示的にグローバルであると宣言されない限り、ローカルとみなす
・pythonソース | ・プログラム構造 | ・トレース資料 | ・解析資料(図) |
def heapify(arr, n, i):
    largest = i  # 親ノードを最大値として初期化
    left = 2 * i + 1  # 左の子ノードのインデックス
    right = 2 * i + 2  # 右の子ノードのインデックス

    # 左の子ノードが親ノードより大きい場合、最大値を更新
    if left < n and arr[left] > arr[largest]:
        largest = left

    # 右の子ノードが親ノードより大きい場合、最大値を更新
    if right < n and arr[right] > arr[largest]:
        largest = right

    # 最大値が親ノードでない場合、親ノードと最大値を入れ替えて再帰的にheapifyを呼び出す
    if largest != i:
        arr[i], arr[largest] = arr[largest], arr[i]
        heapify(arr, n, largest)

def heapsort(arr):
    n = len(arr)

    # ヒープ木を構築(最初に一度、配列をヒープに変換)
    for i in range(n // 2 - 1, -1, -1):
        heapify(arr, n, i)

    # 配列をヒープから取り出し、ソートを行う
    for i in range(n - 1, 0, -1):
        arr[i], arr[0] = arr[0], arr[i]  # 最大値を配列の末尾に移動
        heapify(arr, i, 0)  # ヒープのサイズを減らして再度ヒープ化

# ソートするデータを用意
data = [64, 34, 25, 12, 22, 11, 90]
print("Before sorting: ", data)
heapsort(data)
print("After sorting: ", data)
| オープン講座 (Youtube) | 1 ゼロからはじめるPython入門講座 2 学習方法でお悩みの方はご覧ください。 3 さくっと業務改善・GAS講座「メルマガスタンドを作ろう」 4 ちょこっと副業 Rails講座1「問合せフォームを作ろう」 5 ちょこっと副業 Rails講座2「クローラーを作ろう」 6 ちょこっと副業 Rails講座3「APIを使って読書管理アプリを作ろう」 7 ちょこっと副業 Rails講座4「APIを使って読書管理アプリを作ろう」 8 ゼロからはじめる機会学習講座 9 テックジムの無料講座一覧 |
| オープン講座 (補助資料) | 受講者専用 テキストのダウンロードページ |
| 個別講座 | 効率アップ10のポイント 学習の目的別ルート |
| 補足情報 | GAS(Google Apps Script)の紹介 Googleのサービスを有効活用する Railsの紹介 「Ruby」で書かれたWebアプリケーションフレームワーク |
| Python基礎コース(初心者向け) | カリキュラムの概要 https://techgym.jp/about/python_course/ |
| 「AI・機械学習」入門講座 | 2020-06-19 これだけは知っておきたい「機械学習」ビジネス活用講座 |
| Pythonで始める最適化入門 紹介ページ | 2022-03-23 講演のプロモーション |
| 〃 講演内容(動画) | 2022-03-23 AI活用から≪意思決定≫の道筋まで見つける方法 |
実行例は「stupa.sarnath」の「Google Colabotry」環境に保存してある
任意の値を引数にセットすることでその値に対応した結果を得る
def hello():
    print ('Hello')
hello()

# Hellodef add(a, b):
x = a + b
return x
answer = add(70, 30)
print (answer)
# 100 関数内で可変長引数としてアスタリスク(*)1個を前に付ける
指定できる可変長引数は1個だけ
def sample(name1, name2, *args):
    print (name1)
    print (name2)
    print (args)
sample('Sato', 'Tanaka', 'Suzuki', 'Honda')
関数内で可変長引数としてアスタリスク(**)2個を前に付ける
指定できるキーワード引数は1個だけ
ただし、キーワードを付けて複数の項目を指定できる
def sample(name1, **params):
    print (name1)
    print (params)
sample('Sato', 年齢=30, 性別='男')


